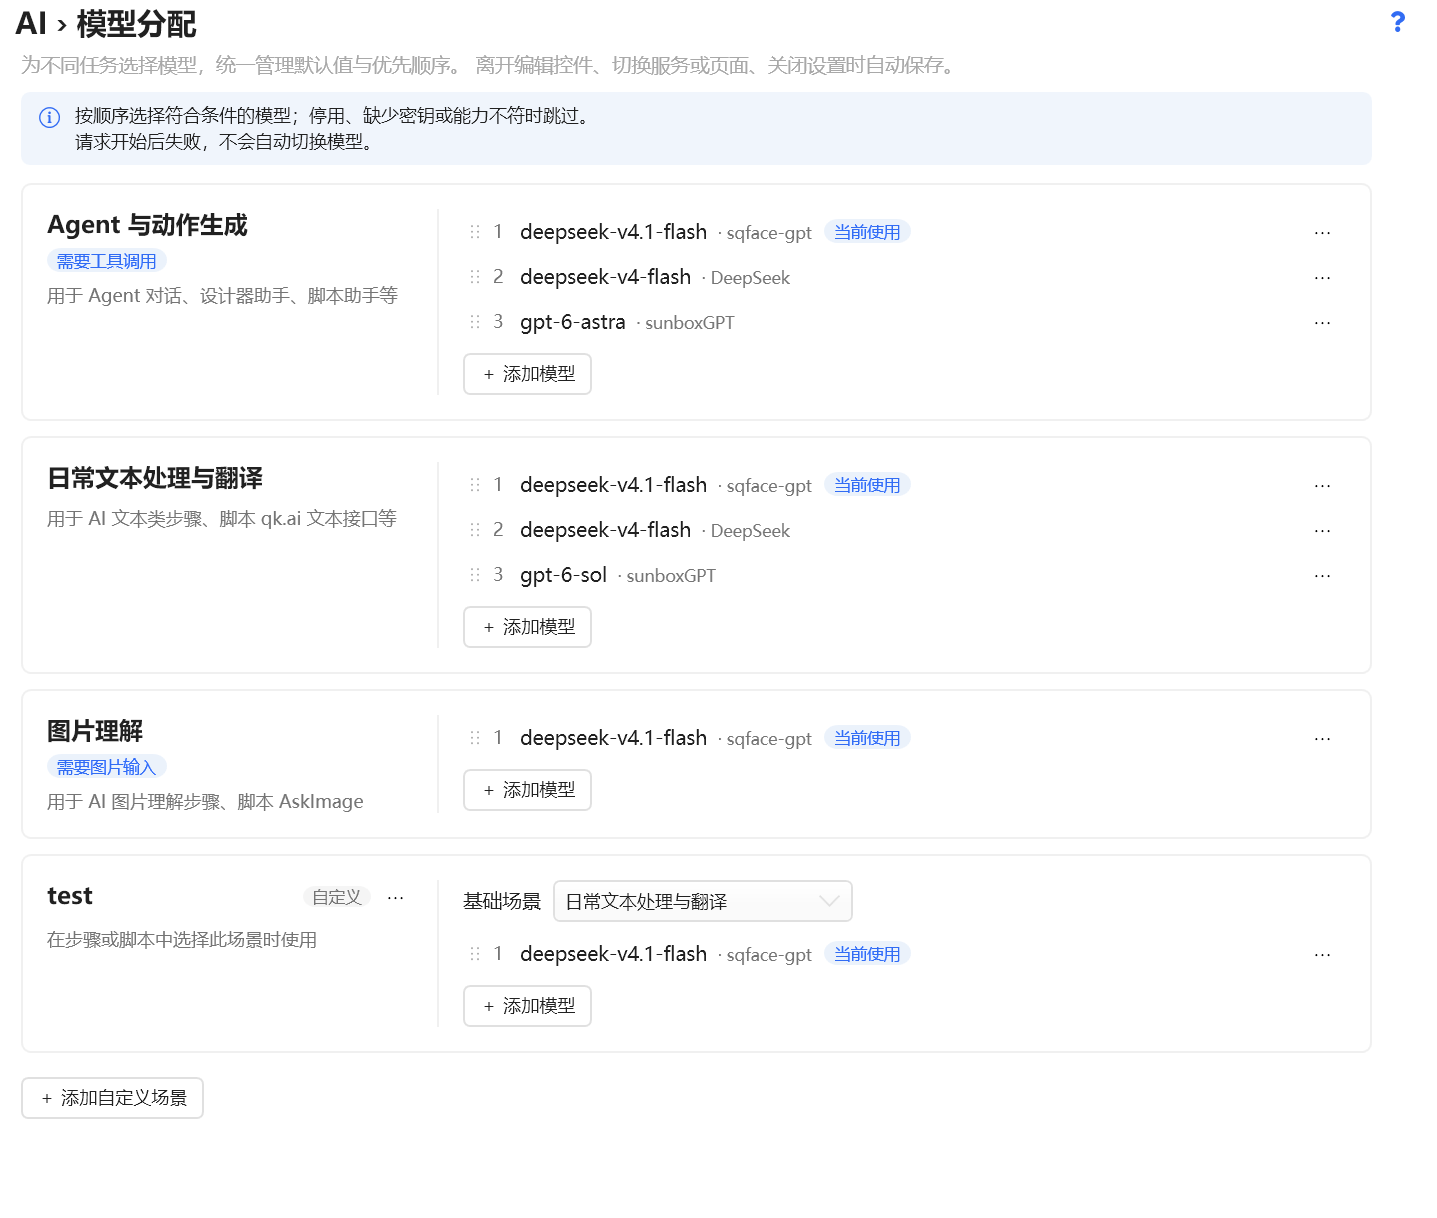
没太理解, 这里要么处理文本,要么处理图片,其它不太适用吧。
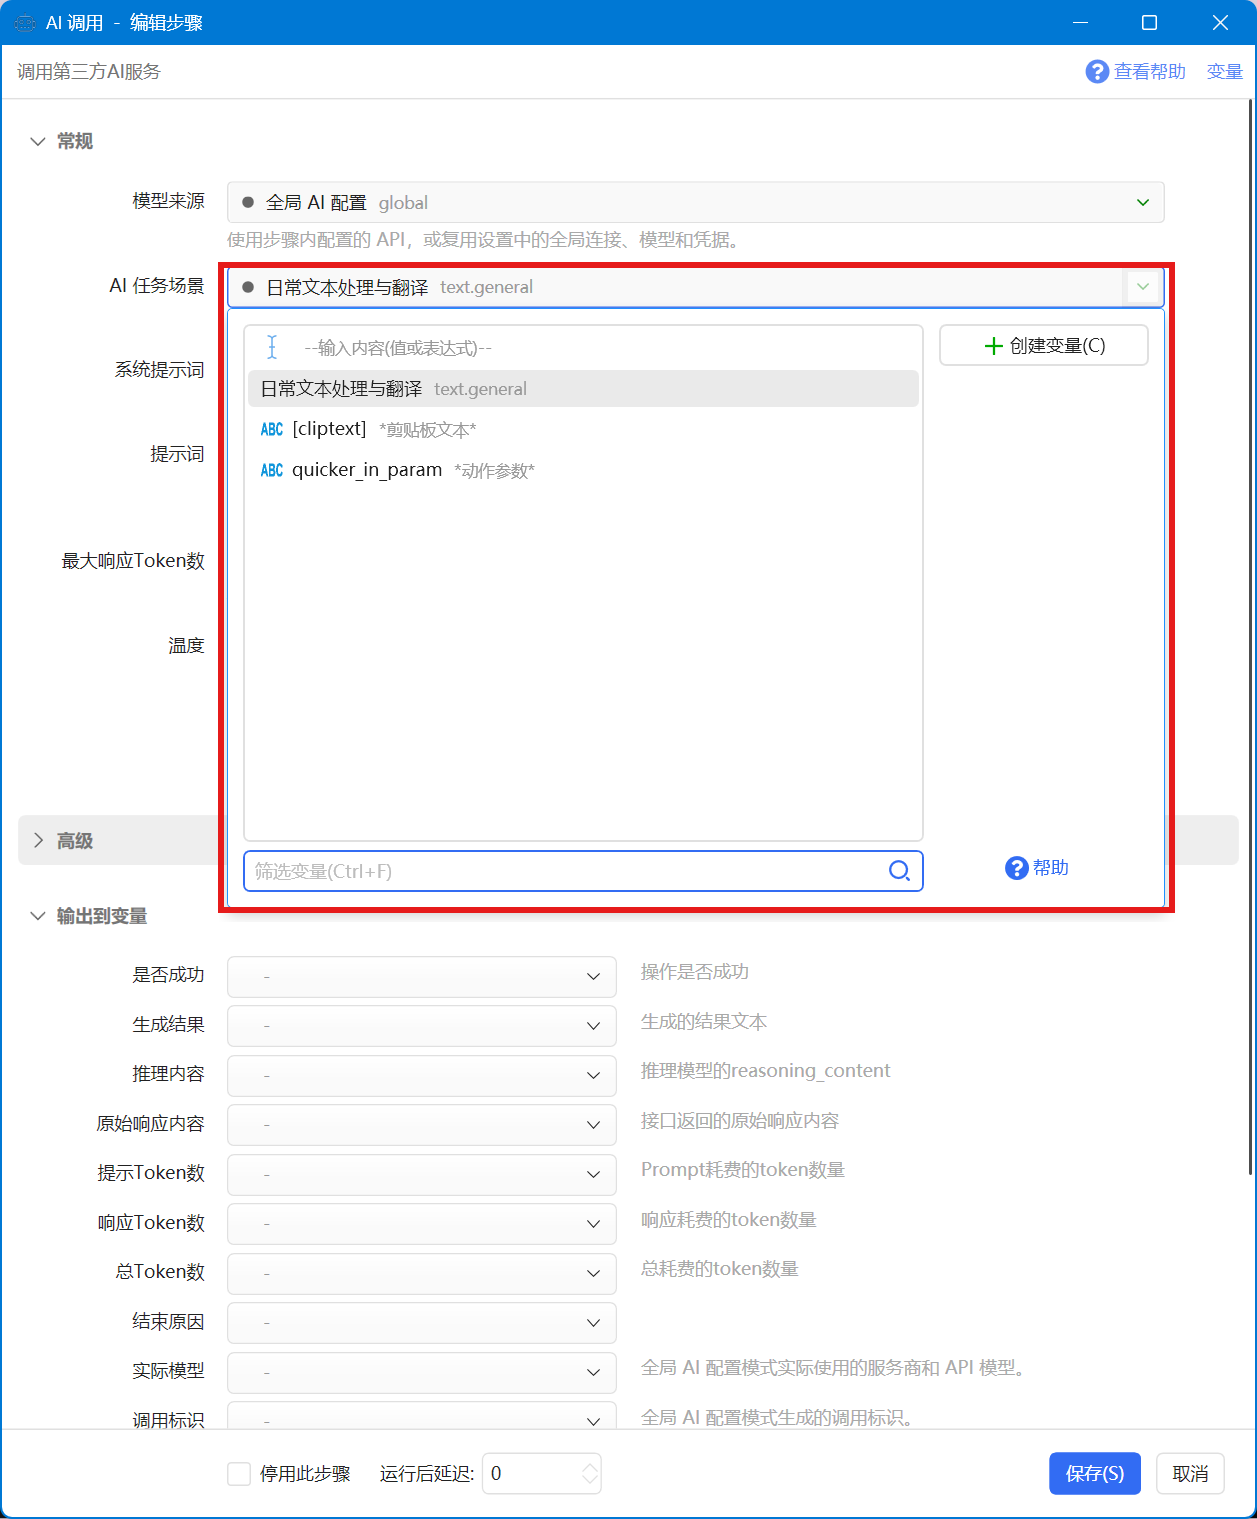
就是在动作步骤里面可以选择用哪个模型
目前的设计在于避免直接在动作里选择设置模型。 因为模型随时会变,但是动作逻辑是固定的。 可以通过上面设置里,按用途添加自定义场景,然后在动作里引用自定义场景。

 京公网安备 11010502053266号